DeepSeek 标志 DeepSeek OFFICIAL
R1 全面就绪

探索认知未至之境DeepSeek 官方入口

这条路从长安出发,终点是 DeepSeek网页版:打开浏览器就能和 DeepSeek-R1 对话,不用安装,也不用配环境。 想把模型接进自己的系统,在玉门关领一份通关文牒——也就是 DeepSeek api开放平台 的密钥与接口说明; 想知道模型到底靠不靠谱,疏勒那一站用 DeepSeek Harness 把每一次评测的题集、参数和分数都摊开给你看。

长安 → 凉州 → 敦煌 → 玉门关 → 疏勒 → 网页版
DEEPSEEK_REASONING_CONSOLE.SH
DeepSeek网页版深度思考对话界面
> 题目:一支商队每天走 40 里,驿站间隔 120 里……
> 思考 先算单程天数,再看补给点是否覆盖……
> 核对 第三站补给不足,回退重算路线
> 结论已生成,共 3 步推理,1 次自我纠错
● 显式思维链已闭环 R1 · 128K
第一站 凉州 · 先看驼队的底子

DeepSeek AI 靠什么走远路

长途商队拼的是脚力和补给。大模型也一样,能走多远取决于底层结构。下面四件,是 DeepSeek 能在长推理里不掉队的原因。

SPEC // 01

MLA 注意力

把键值缓存压进一个低维的潜在向量里,推理时再还原。同样的显存能装下更长的对话,长文本也不容易“忘了前面说过什么”。

SPEC // 02

纯强化学习

R1 的推理习惯主要靠强化学习练出来:答对给分,答错扣分。模型因此学会先写草稿、发现问题再回头改。

SPEC // 03

256 专家 MoE

参数总量很大,但每次只叫醒少数几个专家干活。好比驿站里人很多,接哪单货只派最熟这条路的那几个。

SPEC // 04

128K 上下文

一次能读进整本合同、一个中型代码仓库或几十页论文,再针对某一段追问,不用来回拆分粘贴。
DeepSeek AI 模型结构示意图

里程 0480 km
这四项不是各自为战:MoE 管算力分配,MLA 管记忆,强化学习管推理习惯,128K 窗口给它们留出施展的地方。合在一起,才有你在网页版里看到的那种“先想再答”。

第二站 甘州 · 驼背上驮的货

这些活,DeepSeek 已经在帮人干

不是概念演示,是用户每天真正丢给它的任务。挑一个和你手头工作最像的,直接去网页版试。

老代码重构

把几千行没人敢动的旧模块贴进去,让它先画出调用关系,再一块块拆。改动建议会附上理由。

奥数证明

竞赛题、几何证明、数列不等式。打开深度思考,它会把每一步推导写出来,错了也会自己指出来。

并购尽调审查

几百页的协议一次读完,列出对赌、回购、竞业这类条款的位置和风险点,律师再逐条复核。

量化回测

描述策略思路,它写出回测脚本并解释每个参数。跑完的结果贴回来,还能帮你找过拟合的痕迹。

Agent 编排

通过 API 的函数调用,让模型自己决定先查库存、再算运费、最后下单,每一步都留日志。

离线私有部署

开源权重可以放进自己的机房,数据不出内网。适合对合规要求严格的银行、医院和制造企业。

第三站 敦煌 · 驿站里的货单

选哪匹骆驼:模型货单

三个型号,用途不同。价格为 DeepSeek api开放平台每百万 Token 的参考价,实际以控制台为准。
DeepSeek-R1deepseek-reasoner · 主推
先推理后作答,会输出完整思维链。数学、代码和多步分析首选。
  • 128K 上下文
  • 思维链可见
  • 函数调用
¥4 / ¥16输入 / 输出 · 每百万 Token在网页版试用 →
DeepSeek-V3deepseek-chat
通用对话主力,响应快,写作、翻译、问答和日常编程都够用。
  • 128K 上下文
  • JSON 输出
  • 缓存命中降价
¥2 / ¥8输入 / 输出 · 每百万 Token查看接入说明 →
开源权重版本地部署 · 蒸馏系列
从 1.5B 到 70B 的蒸馏模型,可在单卡或小集群上跑,适合内网与边缘设备。
  • 可商用许可
  • Ollama / vLLM
  • 离线运行
自备算力无调用费用部署教程 →
DeepSeek api开放平台控制台与密钥管理页面
第四站 玉门关 · 领通关文牒

出关之前,先把 API 接上

  1. 01

    注册并创建密钥

    在 DeepSeek api开放平台登录后进入“API Keys”,新建一把密钥。密钥只显示一次,记得马上存好。

  2. 02

    替换接口地址

    接口与 OpenAI 格式兼容。已有代码只需把 base_url 改成 DeepSeek 的地址,模型名换成 deepseek-chat 或 deepseek-reasoner。

  3. 03

    发出第一条请求

    调用 /chat/completions,拿到回复后看一眼用量字段,确认计费正常,就可以放进正式环境。

通关文牒 · 摘要

接口路径
POST /chat/completions
鉴权方式
Authorization: Bearer <API_KEY>
可用模型
deepseek-chat / deepseek-reasoner
完整说明
帮助中心 · 通关文牒 →
第六站 龟兹 · 账本上的数

走过这段路的记录

99.8%近 90 天网页版服务可用率
¥0.14一次万字长对话的平均调用成本
128K单次对话可读入的上下文长度
60+ QPS单个企业账号默认并发上限
harness · run_eval.sh
# 用固定题集跑一轮 R1,结果写入 reports/
$ harness run \
    --model deepseek-reasoner \
    --suite math-500,humaneval,mmlu-pro \
    --temperature 0.6 --seed 42

[suite]  math-500     97.3   312s
[suite]  humaneval    92.1   188s
[suite]  mmlu-pro     84.0   640s
done  报告已保存 reports/r1-2026-11.json
第七站 疏勒 · 验货

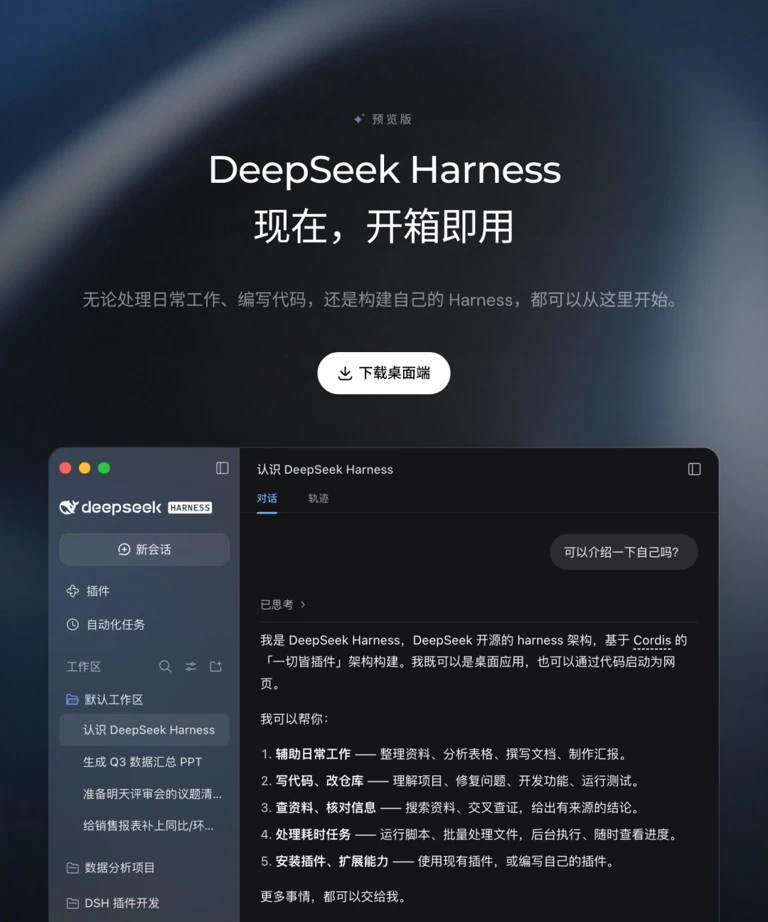
DeepSeek Harness:分数要能复现

同一套题,同一组参数

题集、温度、随机种子都写死在配置里。换个人、换台机器再跑一遍,分数应该落在同一个区间。对不上,就说明哪里出了问题。

不只看总分

每道题的输入、输出和耗时都留档。你可以挑出模型做错的那几题,看它在思维链里是从哪一步开始走偏的。
歇脚处 路上常被问到的事

常见问题

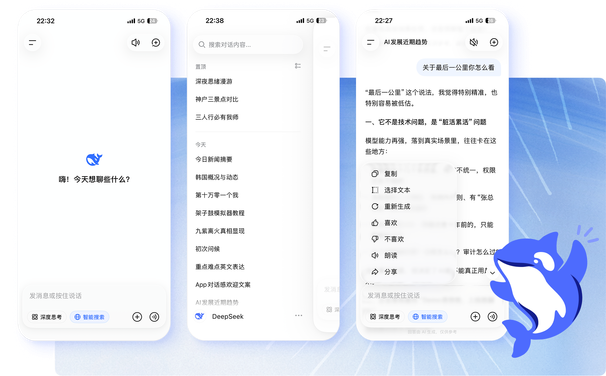
不需要。打开 DeepSeek网页版入口,在浏览器里就能直接对话,电脑和手机都可以用。想要桌面快捷方式,把页面添加到收藏夹或主屏幕即可。
在对话框下方打开“深度思考”开关,模型会先写出推理过程,再给出结论。数学、代码和需要多步分析的问题建议打开;普通闲聊关掉会更快。
按输入和输出的 Token 数量分别计费,缓存命中的输入更便宜。新账号通常有试用额度,具体单价以 DeepSeek api开放平台控制台公布的价格为准。
一套评测流程:用固定题集和固定参数跑模型,记录每题的输出、分数和耗时,方便对比不同版本,也方便你复现官方公布的结果。
驿报 最近从路上传回来的消息

动态

网页版新增对话分组

可以把同一个项目的多段对话放进一个文件夹,切换时上下文不丢。

去看看 →

API 缓存命中价格下调

重复前缀的请求更省钱,长系统提示词的应用受益最明显。

计费说明 →

Harness 公开新一期评测报告

补充了长文本检索和多轮工具调用两个题集。

查看 →

本地部署教程更新

增加了在 Windows 上用 Ollama 运行蒸馏模型的步骤。

阅读 →

网页版支持上传 PDF 与表格

单个文件最大 100MB,解析后可以直接针对某一页提问。

试用 →
DeepSeek 用户社区活动现场